Welttag des Buches: Wie KI das Urheberrecht verändern wird
Diese Einleitung wurde mithilfe von KI geschrieben. Ist es dann noch meine Einleitung? Ich habe sie nicht von ChatGPT verfassen lassen, aber ich habe es meinen Text redigieren und mir Inspiration geben lassen. Ich bin nicht die Einzige, die das tut – und es werden wohl mit der Zeit immer mehr werden. Wie wird Künstliche Intelligenz sich auf Kreative und Kunstschaffende auswirken? Welche rechtlichen und moralischen Fragen kommen auf, wenn KI an Kunst beteiligt ist? Wann ist die Nutzung von KI in Ordnung, wann nicht, gibt es „zu viel“ KI in einem Werk? Den Welttag des Buches habe ich zum Anlass genommen, über diese Probleme ein wenig zu reflektieren. Grundsätzlich kommen sich das Urheberrecht und die KI in zweierlei Punkten in die Quere: beim Input und beim Output.
Urheberrecht und Input
Damit KI-Sprachmodelle sinnvoll auf Fragen antworten und Text generieren können, benötigen sie eine gewaltige Menge an Daten. Beispielsweise ‚trainiert‘ KI mithilfe von Textdaten, in denen sie Muster erkennen lernt. Dies geschieht vor allem durch statistische Algorithmen. Eine KI „weiß“ also nicht im traditionellen Sinne, was sie sagt. Sie berechnet – vereinfacht gesagt – die Wahrscheinlichkeit für das nächste Wort in einer Aneinanderreihung von Worten.
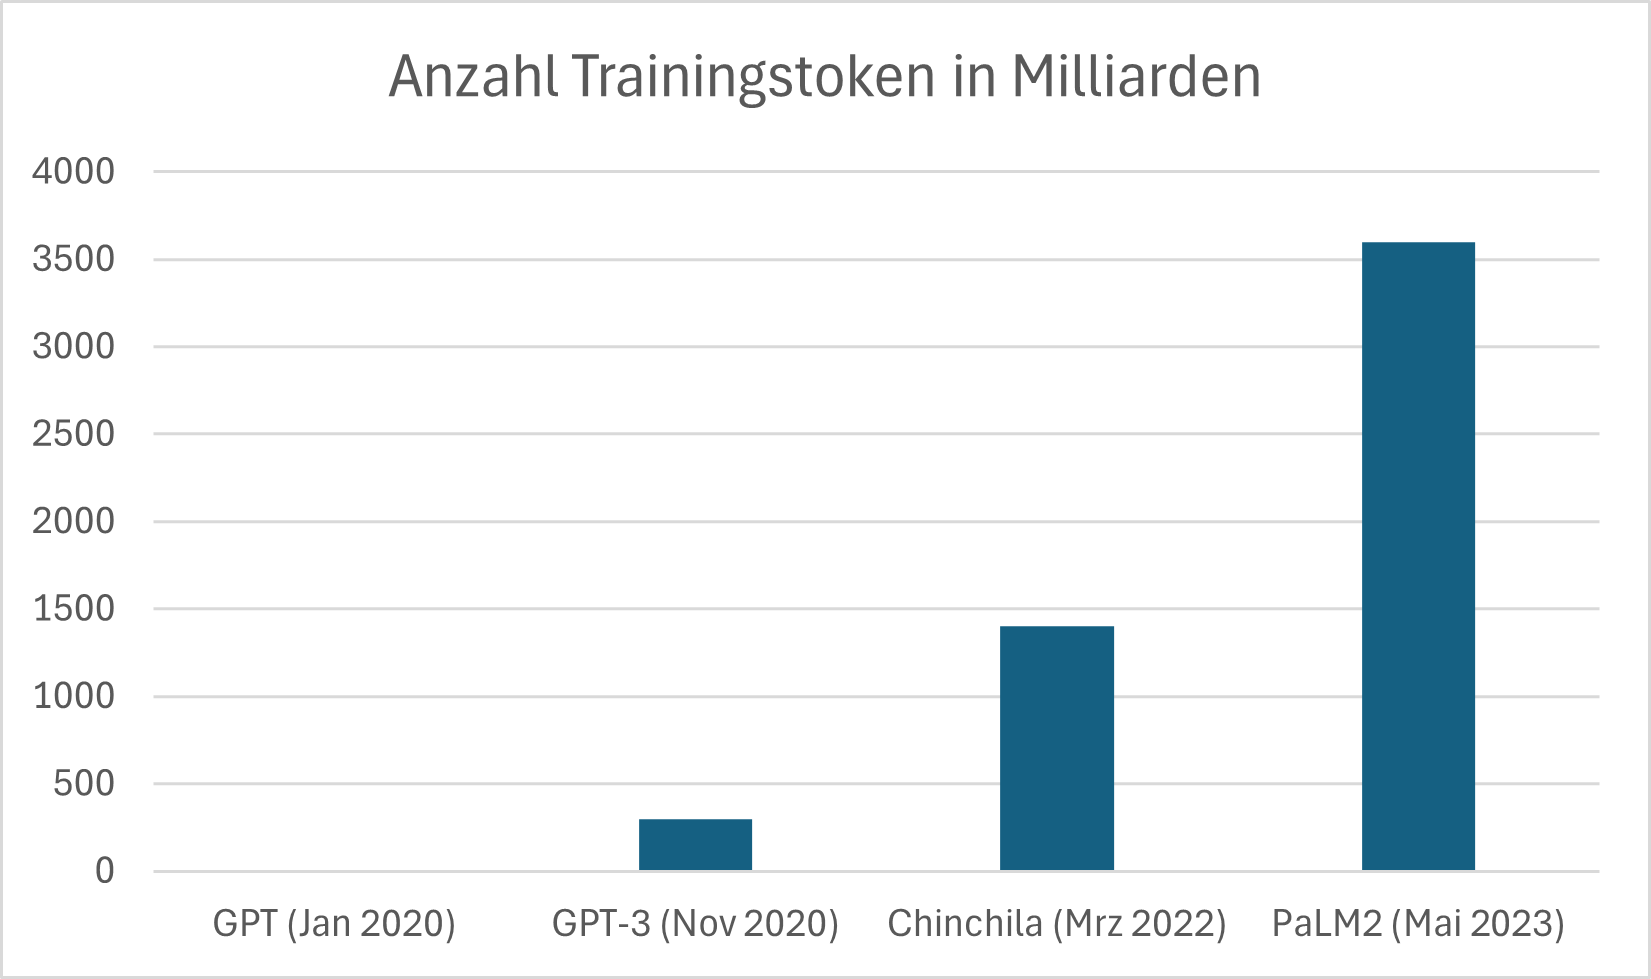
Je größer die Datenmenge ist, desto genauer werden die Antworten des Modells. 2020 wies der Physiker Dr. Jared Kaplan von der Johns Hopkins University diesen Effekt nach. Die Forschenden seien überrascht gewesen, wie präzise diese „Skalierungseffekte“ wären – im Grunde seien sie wie physikalische Gesetze, sagte er der New York Times. Der Datenhunger der KI-Firmen wuchs also. Im Jahr 2020 umfasste die maximale Menge an Trainingsdaten 30.000 sogenannte Token. Im März 2022 trainierte das Google-Modell Chinchilla bereits mit 1,4 Billionen Token, einer Zahl mit zwölf Nullen also. Zum Vergleich: Eine Millionen Sekunden sind circa zwölf Tage. Eine Milliarde Sekunden sind fast 12.000 Tage oder circa 32 Jahre. Und eine Billion enthält tausend Milliarden.
Ab einem gewissen Punkt waren öffentlich zugängliche Daten allerdings erschöpft – alle Wikipedia-Einträge, Reddit-Posts, GitHub-Codes und Quizlet-Fragen. Doch das Rennen um das beste KI-Modell war noch längst nicht gewonnen; deshalb suchten KI-Firmen nach weiteren Lösungen. Sam Altman, CEO des Unternehmens hinter ChatGPT (OpenAI), sprach von der Zukunft der sogenannten „synthetischen Trainingsdaten“. Dabei trainiert die KI mit KI-generierten Textdaten. Doch um an natürliche Sprachdaten zu gelangen, schlugen die großen KI-Unternehmen Wege ein, die mindestens fragwürdig, wenn nicht sogar illegal waren – das deckte die New York Times auf. OpenAI entwickelte beispielsweise das Tool Whisper, welches Sprache in Text umwandelt, zum Beispiel von YouTube. OpenAI soll dabei gewusst haben, dass sie sich in einer rechtlichen Grauzone bewegen – wie anonyme Mitarbeitende von OpenAI der New York Times mitteilten. Auch Google verwendete transkribierte YouTube-Videos für ihre KI. Meta hingegen diskutierte in einem Meeting den potenziellen Kauf des Verlagshauses Simon & Schuster, um an eine große Menge lizensierter Bücher zu gelangen. Der Verlag verlegt unter anderem Stephen King. Aufzeichnungen der Meetings belegen außerdem, dass Meta in Betracht zog, urheberrechtsgeschützte Daten aus dem gesamten Internet zu verwenden – auf das Risiko hin verklagt zu werden.
Rechtliche Ausgangslage
Erste rechtliche Konsequenzen folgten. Im Juni 2024 verklagten die Autoren Paul Tremblay und Mona Wad OpenAI wegen Urheberrechtsverletzung (Copyright Infringement). Das Unternehmen soll geschützte Werke illegal bezogen und sie als Trainingsdaten verwendet haben. Die Kläger sprachen von einer möglichen Sammelklage. Diverse Nachrichtenmedien, die New York Times, die New York Daily News und das Center for Investigative Reporting, klagten ebenfalls gegen OpenAI und Microsoft, den wichtigsten Geldgeber des Konzerns. Auf der Seite der visuellen Künste finden wir den Fall Andersen v. Stability AI. Webcomic-Zeichnerin Sarah Andersen beschreibt in ihrem Gastbeitrag ihren Schock, als sie erfährt, dass KI den Stil ihrer Bilder imitiert, wenn man ihren Namen verwendet. Sie und einige weitere Künstler:innen stellten eine Sammelklage gegen Stability AI zusammen – das Unternehmen steckt hinter dem Text-zu-Bild-Generator Stable Diffusion. In den USA wurde bei keinem der Fälle ein endgültiges Urteil gefällt. Es liegt jedoch auf der Hand, dass die Entscheidung richtungsweisend für die Verwendung geschützter Werke für KI-Training sein wird.
In Deutschland stehen die Sterne eher günstig für die KI. Text- und Data-Mining[1] ist nach § 44b des Urheberrechtsgesetzes eine Einschränkung des Urheberrechts, beispielsweise für wissenschaftliche und Forschungszwecke (§ 60d UrhG). Auf dieser Grundlage wies das Landgericht Hamburg eine Klage eines Fotografen gegen das Forschungsnetzwerk Laion zurück. Das Netzwerk hatte dasselbe Datenset entwickelt, gegen das Sarah Andersen et al. geklagt hatten. Die Entscheidung könnte für Deutschland und die EU richtungsweisend im Umgang mit KI-Training sein.
Das ist die rechtliche Ausgangslage. Doch wie steht es um die Moral? Ist es richtig, dass große Unternehmen urheberrechtsgeschütztes Material als Trainingsdaten für ihre Modelle nutzen? An der Antwort auf diese Frage scheiden sich vermutlich die Geister. Sie hängt im Grunde von der eigenen Meinung zu folgenden zwei Unterfragen ab: Wie stehe ich zu KI-Modellen generell? Welchen Wert messe ich kreativer Arbeit bei?
Persönlich bin ich zwiegespalten. Denn einerseits sehe ich in der KI die Zukunft; eine Zukunft, die auch dann nicht aufzuhalten ist, wenn wir uns dagegen sträuben. Ich sehe das enorme Potenzial dieser Technologie, die langsam heranwächst. Sie beginnt, ihre rebellischen Teenie-Jahre hinter sich zu lassen und ist ein mächtiges Werkzeug geworden, welches das menschliche Leben in vielen Hinsichten verbessern oder erleichtern kann – in der Informatik, in der Diagnostik, potenziell sogar in der Kriminologie oder in der Politik.
Andererseits weiß ich, was es heißt, sein Geld mit kreativer Arbeit verdienen zu wollen. Es ist eine Arbeit, die ohnehin wenig geschätzt wird. Es ist eine Arbeit, die oft belächelt wird; eine Arbeit, die oft gering entlohnt wird; eine Arbeit, für die ohnehin immer weniger Leute bereit sind, zu zahlen. Wofür, wenn es doch gratis Nachrichtenportale gibt? Wofür wenn es doch PDF-Scans für Bücher gibt, unlimitierte Musik für zehn Euro im Monat, Filme und Serien für fünf? Und in einer Welt, in der eine KI ähnlich gute Bücher verfassen kann wie ein Mensch, warum sollte man noch für Autoren bezahlen?
Copyright im Output
Auf der anderen Seite kommen Urheberrechtsfragen auf, bei dem, was die KI ausgibt. Wenn ich eine Anfrage (Prompt) an die KI stelle, ein Werk zu erstellen, gehört dieses Werk mir oder der KI? Kann einer Maschine überhaupt ein Kunstwerk gehören? Das deutsche und US-amerikanische Recht sagen: Nein. In Deutschland ist nur ein vom Menschen kreiertes Werk urheberrechtsgeschützt. In den USA gab es beispielsweise einen Streitfall wegen folgendem Selfie:
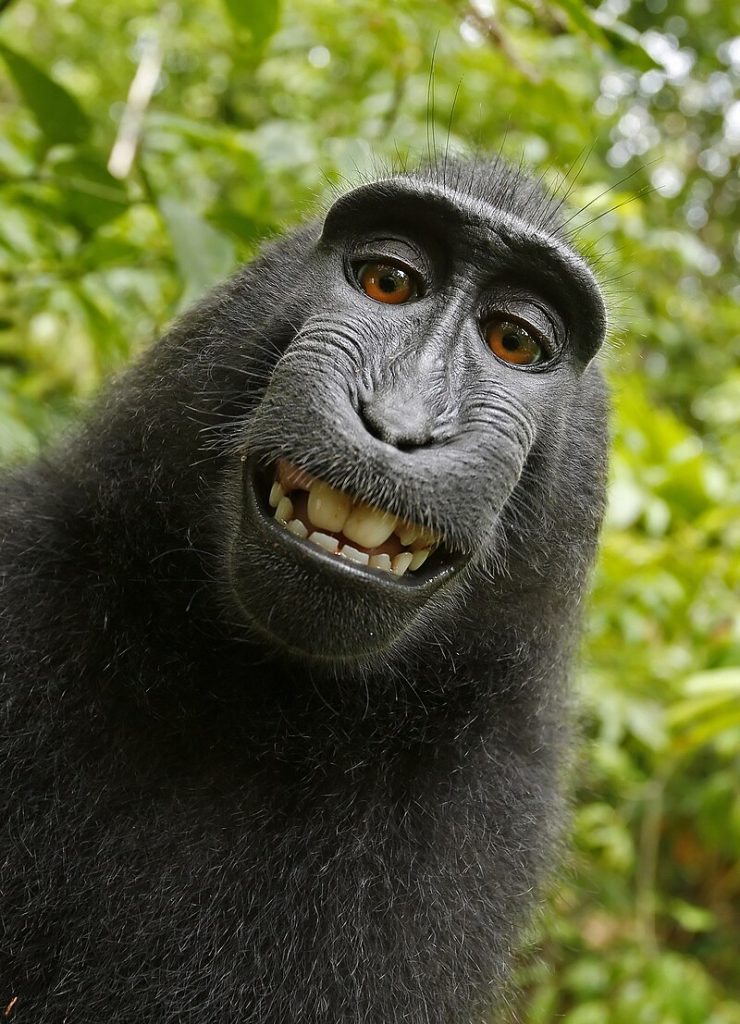
Der Tierfotograf David J. Slater hatte Kameras so platziert, um das Schießen eines Selfies der Tiere zu ermöglichen. Der Fotograf argumentiert, er hätte genug Arbeit investiert, sodass ihm das Urheberrecht zusteht. Die offizielle Meinung des United States Copyright Office (USCO) lautet, dass nicht-menschlichen Erstellern eines Werkes kein Urheberrecht zusteht. Dies könnte Grundlage für künftige KI-erstellte Werke gelten, meinen Rechtsexperten.
Im Vereinten Königreich ist der Schutz eines computergenerierten Werkes seit den 1980ern möglich. Der Autor eines computergenerierten Werkes ist die Person, die „die für die Schaffung des Werks erforderlichen Maßnahmen trifft“ (§ 9 Abs. 3 CDPA, übersetzt von ChatGPT). Ob das die Person ist, die Prompts eingibt oder die Erschaffenden des Tools ist zu diesem Zeitpunkt noch unklar.
Viele Rechtsexperten, wie beispielsweise Andres Guadamuz von der University of Sussex, argumentieren, dass der Grad der Beteiligung eines Menschen entscheidend sein könnte. Dies deckt sich mit dem rechtlichen Konzept der ‚Originalität‘. Im Recht Großbritanniens ist ein Werk „originell“, wenn es das Produkt „des Könnens, der Arbeit oder der Einschätzung“ des Autors ist. Eine ähnliche Definition existiert in der EU. Ist der Prompt an ChatGPT also: „Schreibe mir eine Geschichte mit Drachen und Zauberern“ kann wohl nicht von Originalität die Rede sein.
Grenzfälle
Der Fall um Kris Kashtanovas Comic „Zarya of the Dawn“ zeigt jedoch, wie unscharf die Grenzen noch sind. Kashtanova ließ die Bilder von der KI MidJourney generieren. Zunächst gewährte das USCO Kashtanova vollständiges Urheberrecht auf ihr Werk. Im Februar 2023 revidierte das USCO seine Entscheidung und gewährte es nur noch in Teilen. Die Bilder selbst sind nicht Kashtanovas geistiges Eigentum, nur das Arrangement – sprich: die Charaktere, die Handlung und die Dialoge. Das USCO verglich die Erstellung der Bilder mit dem Anheuern einer bezahlten Künstler:in.
Doch ab wann ist ein Künstler genügend involviert? Das ist nicht nur eine Rechtsfrage, sondern auch eine philosophische. Wie so oft beim Urheberrecht bleibt die Grenze verschwommen zwischen Recht und Unrecht. Wann ist etwas beispielsweise eine Hommage, wann ist es eine Kopie? Jede Künstler:in wird in ihrem Schaffen von anderen Künstler:innen geprägt. Wo hört Inspiration auf, wo fängt Plagiat an? Kann beim KI-Output von ‚Inspiration‘ die Rede sein oder ist es alles im Grunde ein Plagiat? Ist der Output ‚transformativ‘ genug, um die Verwendung urheberrechtsgeschützter Werke zu rechtfertigen?
Fazit
Ich habe KI für diesen Artikel verwendet. KI hat den Artikel nicht geschrieben, aber sie hat mich dabei unterstützt. Sie hat den Artikel überprüft (wie eigentlich jeden meiner Artikel), sie hat mir bei Formulierungen oder gewissen Berechnungen geholfen. Es waren Passagen, die ohne Unterstützung möglicherweise ungenau oder sogar falsch gewesen wären (wie die Übersetzung der Rechtssprache aus dem Englischen). Ich habe die Stellen, an denen eine Passage nicht von mir stammt, gekennzeichnet. Die Authors Guild in den USA hat Labels für Bücher entworfen, auf denen steht „Von einem Menschen geschrieben“. Die Beteiligung von KI an Texten oder Bildern zu kennzeichnen, halte ich für richtig und wichtig. Ähnlich wie bei einem Buch alle Beteiligten und bei einem Foto das verwendete Equipment angegeben wird.
Ich glaube, KI aus der Kunst zu verbannen, ist weder möglich, noch ist es vorteilhaft. KI ist kein selbst-handelndes Subjekt. Sie ist weder gut noch schlecht – sie ist ein Werkzeug. Es kann uns helfen, Zeit zu sparen und unsere Schwächen auszugleichen. Und genauso wie ein Hammer zur Waffe werden kann, kann auch Künstliche Intelligenz missbraucht werden. Vielleicht ist KI kein Urheber. Aber sie kann Redakteurin sein, Lektorin, Taschenrechner, Inspirationsquelle und vieles mehr.
[1] „Die automatisierte Analyse von einzelnen oder mehreren digitalen oder digitalisierten Werken, um daraus Informationen insbesondere über Muster, Trends und Korrelationen zu gewinnen.“